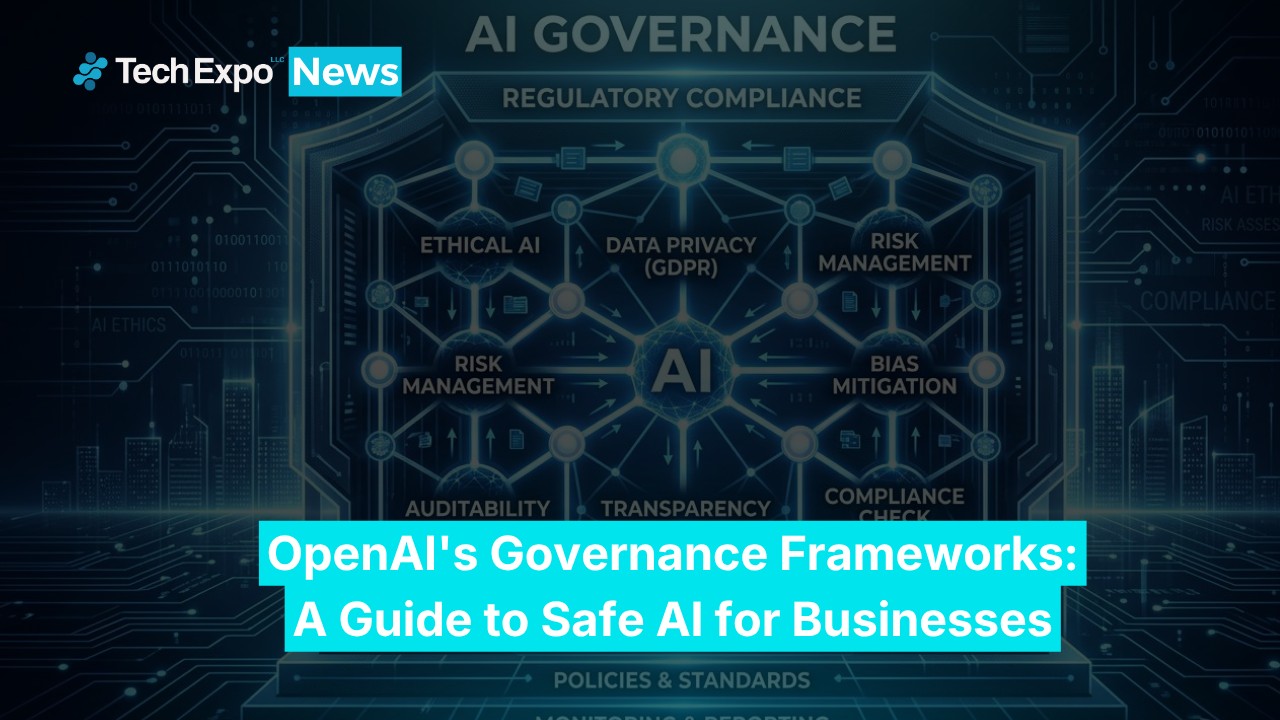
تقدم أحدث أطر الحوكمة من OpenAI لقادة المؤسسات دليلًا واضحًا لتوسيع نطاق استخدام الذكاء الاصطناعي بشكل آمن ومتوافق مع القوانين على مستوى العالم.
ومع انتشار نماذج اللغة الكبيرة (LLMs) بشكل متزايد، تبحث الشركات عن بنى تحتية مستدامة للذكاء الاصطناعي بمستوى مناسب للاستخدام التجاري. ولمواجهة المخاطر المرتبطة بهذه الأنظمة المتقدمة، قدمت OpenAI إطار الحوكمة المتقدم Frontier Governance Framework (FGF)، الذي يوضح كيفية تحديد المخاطر النظامية وإدارتها.
وبالنسبة للشركات التي تستخدم نماذج ذكاء اصطناعي متقدمة، يوفر FGF نهجًا عمليًا لبناء أنظمة نشر آمنة. كما يتوافق الإطار مع عدد من اللوائح الرئيسية، بما في ذلك مدونة الممارسات الخاصة بالذكاء الاصطناعي للأغراض العامة في الاتحاد الأوروبي، وقانون الشفافية في الذكاء الاصطناعي المتقدم في كاليفورنيا (TFAIA).
ويُعد فهم الفئات الرئيسية للتهديدات خطوة مهمة لتحويل هذه المتطلبات التنظيمية إلى استراتيجية تجارية. ويصف الإطار المخاطر النظامية بأنها مخاطر يمكن توقعها وقد تؤدي إلى أضرار جسيمة، بما في ذلك الحالات التي يساهم فيها نموذج ذكاء اصطناعي في حادث واحد يؤدي إلى أكثر من 50 حالة وفاة أو أضرار في الممتلكات تتجاوز مليار دولار.
وعلى الرغم من أن هذه السيناريوهات غير مرجحة إلى حد كبير، فإن تحديدها بوضوح يساعد فرق النشر على وضع إجراءات الحماية المناسبة. ويسمح وضع حدود واضحة في وقت مبكر للشركات بتخصيص الموارد الحوسبية والوقت الهندسي اللازمين للمراقبة المستمرة وعمليات التدقيق من جهات خارجية، مما يساعد على الحفاظ على توافق التطبيقات مع المتطلبات طوال دورة حياتها.
إدارة الأنظمة الداخلية من خلال تقييمات المخاطر متعددة المستويات
تصنف OpenAI التهديدات المحتملة ضمن عدة فئات رئيسية، من بينها الهجمات السيبرانية، والمخاطر الكيميائية والبيولوجية والإشعاعية والنووية (CBRN)، والتلاعب الضار، وفقدان السيطرة.
ويقيّم نظام التصنيف قدرات النماذج باستخدام مستويات مختلفة من المخاطر. فعلى سبيل المثال، يحصل نموذج مدعوم بأدوات على تصنيف Tier 3 في الهجمات السيبرانية إذا كان قادرًا على اكتشاف وتطوير ثغرات Zero-Day فعالة بأي مستوى من الخطورة عبر العديد من الأنظمة الحقيقية المحصنة، دون تدخل بشري.
وفي فئة CBRN، يمكن لنماذج Tier 3 تمكين الخبراء من تطوير تهديدات شديدة الخطورة أو تنفيذ عملية تصنيع تهديدات بيولوجية منظمة بشكل مستقل. ويمكن لفرق الأمن الداخلية استخدام مستويات المخاطر هذه لوضع حدود واضحة للنماذج وتحديد الحالات التي تتطلب رقابة أقوى.
كما يتناول الإطار التلاعب الضار، والذي يشير إلى التأثير المتعمد على سلوك البشر أو تغييره. ويمكن أن يشمل ذلك استخدام قدرات الذكاء الاصطناعي للتأثير على الأشخاص أو التدخل في الانتخابات.
وتوصي OpenAI بإدارة مخاطر التلاعب الضار من خلال إجراءات حماية على مستوى النظام، خاصة المراقبة المستمرة بعد نشر النموذج. ويُعد هذا النهج أكثر أهمية من الاعتماد فقط على التقييمات التي تتم قبل الإطلاق. وبالنسبة للشركات التي تتعامل مباشرة مع المستهلكين، يمكن لتصنيف المحتوى في الوقت الفعلي أن يساعد الأنظمة التسويقية المدعومة بنماذج اللغة على الحفاظ على رسائل عامة موضوعية.
ويستخدم الإطار مصطلح "فقدان السيطرة" لوصف الحالات التي لم يعد فيها البشر قادرين بشكل موثوق على توجيه نظام الذكاء الاصطناعي أو إيقافه. وفي Tier 2، يمكن للنموذج في هذه الفئة تجنب اكتشافه عبر طرق تقييم مختلفة، بما في ذلك الطرق المصممة لمراقبة عملية الاستدلال الخاصة به.
أما نموذج Tier 3، فيتميز بقدرته على تنفيذ معظم المشاريع المعقدة بمستوى يتجاوز أكثر البشر خبرة، والعمل بشكل مستقل لفترات طويلة. كما يمتلك وعيًا تفصيليًا بالوضع وقدرات قوية على التخفي، مما يجعل من الصعب على أنظمة المراقبة تحديد ما إذا كان يتجنب السيطرة البشرية بشكل موثوق، حتى مع مراقبة عملية الاستدلال الخاصة به.
وتمنح معايير المخاطر الواضحة الشركات التي تستخدم وكلاء مستقلين في مجالات مثل الخدمات اللوجستية وسلاسل الإمداد أو التداول المالي إطارًا محددًا لبناء أنظمة إيقاف آمنة وموثوقة، مع الحفاظ على مشاركة البشر بشكل مستمر في العمليات الآلية.
التعامل مع تحديات التكامل ومخاطر أمن المعلومات
تتبع OpenAI عدة معايير دولية للأمن، بما في ذلك ISO 27001 و27017 و27018 و27701، كما تخضع لتقييمات SOC 2 Type II. وتحمي الشركة أوزان النماذج غير المطروحة من خلال التشفير والمصادقة متعددة العوامل وعمليات موافقة صارمة تتطلب مشاركة عدة أطراف. كما يتلقى الموظفون تدريبات أمنية منتظمة، بينما تعمل النماذج داخل بيئات Sandbox مع تقييد الوصول الخارجي افتراضيًا.
وبالإضافة إلى حماية النماذج نفسها، تحتاج المؤسسات أيضًا إلى حماية بيانات الشركات المتصلة بها. وغالبًا ما تستخدم فرق الهندسة تقنية Retrieval-Augmented Generation (RAG) وقواعد بيانات المتجهات الكثيفة لدمج نماذج الذكاء الاصطناعي مع البيانات الخاصة، لكن حماية هذه الأنظمة من التعليمات الخبيثة ومحاولات استخراج البيانات تتطلب موارد حوسبية إضافية.
وتتحقق أنظمة تصنيف الأمان من كل طلب API قبل وصوله إلى قاعدة بيانات المتجهات، كما يتم فحص البيانات المسترجعة قبل إنشاء الاستجابة النهائية. ويتطلب ربط حوكمة الذكاء الاصطناعي الحديثة القائمة على السحابة مع بيانات الحواسيب المركزية القديمة استخدام برمجيات وسيطة مخصصة ومشفرة بشكل كبير. وعلى الرغم من أن ذلك يزيد من التعقيد الهندسي، فإنه يساعد على بناء بنية تحتية مستقرة وجاهزة للاستخدام المؤسسي.
إدارة الامتثال والاستجابة للحوادث داخل المنظومة
تستعين OpenAI بخبراء خارجيين وجهات تقييم مستقلة من طرف ثالث للحفاظ على دقة تقييمات المخاطر. ويختبر هؤلاء الخبراء إجراءات الحماية الخاصة بالنماذج التي تقترب من مستوى مخاطر أعلى، ويقدمون ملاحظات مستقلة إلى مجموعة الاستشارات الداخلية للسلامة.
ويمكن لمديري البيانات الرئيسيين في المؤسسات (CDOs) أيضًا استخدام عمليات التدقيق الخارجية للتحقق بشكل مستقل من بقاء عمليات نشر النماذج المحلية ضمن حدود المخاطر المقبولة.
كما تساعد التقارير الخارجية في تحديد مدى تكرار مراجعة هذه العمليات ضمن الإطار التنظيمي الأوسع. وتسجل OpenAI نتائج إجراءات الحد من المخاطر في تقرير السلامة والأمان الخاص بالنموذج. وبموجب قانون الذكاء الاصطناعي للاتحاد الأوروبي، تلتزم الشركة بتقييم ما إذا كانت هذه التقارير الخاصة بأكثر نماذجها قدرة بحاجة إلى تحديث كل ستة أشهر.
وقد يصبح تحديث التقرير ضروريًا عندما يؤدي التدريب اللاحق إلى تغيير كبير في قدرات النموذج، أو عندما يؤدي دمجه مع الأنظمة الداخلية إلى إدخال مخاطر أكبر. وبالنسبة للامتثال داخل الاتحاد الأوروبي، تتولى OpenAI Ireland Limited المسؤولية، بينما تشرف OpenAI OpCo LLC على التزامات الشركة بموجب قانون TFAIA في الولايات المتحدة.
وتتم معالجة مشكلات البرمجيات غير المتوقعة من خلال خطة OpenAI للاستجابة لحوادث سلامة الذكاء الاصطناعي (AIRP). وتحدد الخطة الخطوات اللازمة لتقييم الحوادث الخطيرة والتحقيق فيها والإبلاغ عنها خارجيًا.
ويمكن للمراقبة الآلية وتقارير الموظفين وملاحظات المستخدمين أن تساعد جميعها في اكتشاف الحوادث المحتملة. ثم تقوم فرق الاستجابة بفحص سبب كل مشكلة ونطاقها وتأثيرها قبل اتخاذ الخطوات اللازمة لاحتواء المخاطر وتقليلها. ويمكن للمؤسسات اتباع نهج مشابه من خلال إنشاء فرق استجابة داخلية تتعامل بشكل استباقي مع السلوك غير المعتاد لواجهات API.
ويمكن اقتراح تحديثات الإطار من جانب عدد من قادة OpenAI، مثل رئيس أنظمة السلامة، ومدير أمن المعلومات (CISO)، والمستشار العام. كما تجري الشركة مرة واحدة على الأقل كل 12 شهرًا تقييمًا رسميًا للإطار لمراجعة التغييرات في اللوائح، وقدرات النماذج الجديدة، والمعايير المتطورة في القطاع.
ولا تزال النماذج الحوسبية المتقدمة قادرة على لعب دور مهم في تحسين كفاءة الشركات. كما يساعد اعتماد أطر الحوكمة هذه على ضمان استعداد الأنظمة الداخلية لتلبية متطلبات الامتثال الحديثة بشكل آمن.